

9月23日,觅蜂科技将正式发布「觅蜂派」,这是业界首个全品类高质量物理AI数据众包服务平台,构建全球最大具身智能数据采集网络。MEgo数采设备(View/Gripper)+觅蜂派APP+MEgo Engine数据引擎,能实现“人即采集节点”,覆盖99%以上真实工作场景,并开放“百万机器人训练师”招募通道。
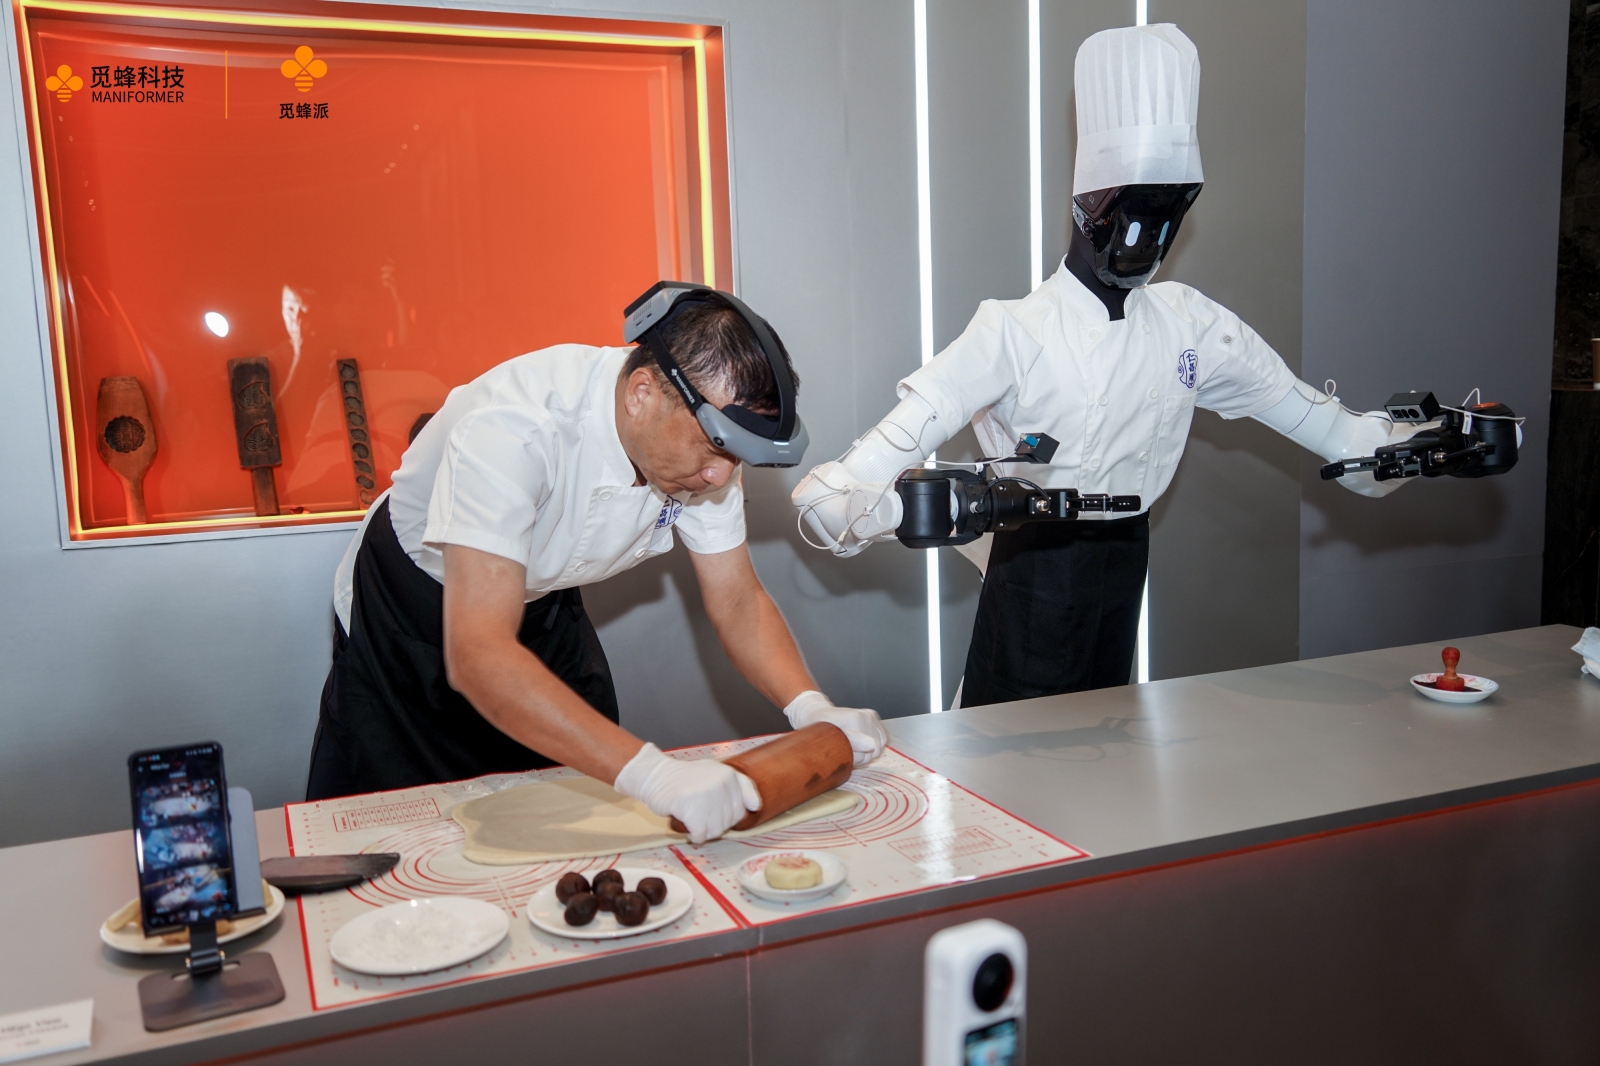
在此之前,我去了趟上海浦东,在觅蜂科技的数采工厂里体验了一把他们刚下线的MEgo设备,而且拿了一台回家。说实话,带回来我以为就是走个过场,没想到5个小时下来,我真的赚了78块钱,还顺手搞明白了一个困扰我很久的问题:机器人到底是怎么学会干活的?
01
这78块钱是怎么赚的?
我拿到的是一套叫MEgo View的设备。头戴部分像一个轻量化的运动相机,有五个摄像头,能拍到超过300度的视野,专门记录第一人称视角动作数据。
安装?比我想象的简单太多。没有缠线,没有基站,没有背在身上的电脑。这个设备安上电池和SD卡,戴上就能用,电池可以磁吸快换,全程无线。
然后我在APP商店下载并且打开一个叫“觅蜂派”的APP,选取了一个贴近的角色,然后陆续在任务大厅接了20多个家用任务:摆盘、擦桌子、整理物品、泡茶……都是些日常家务。
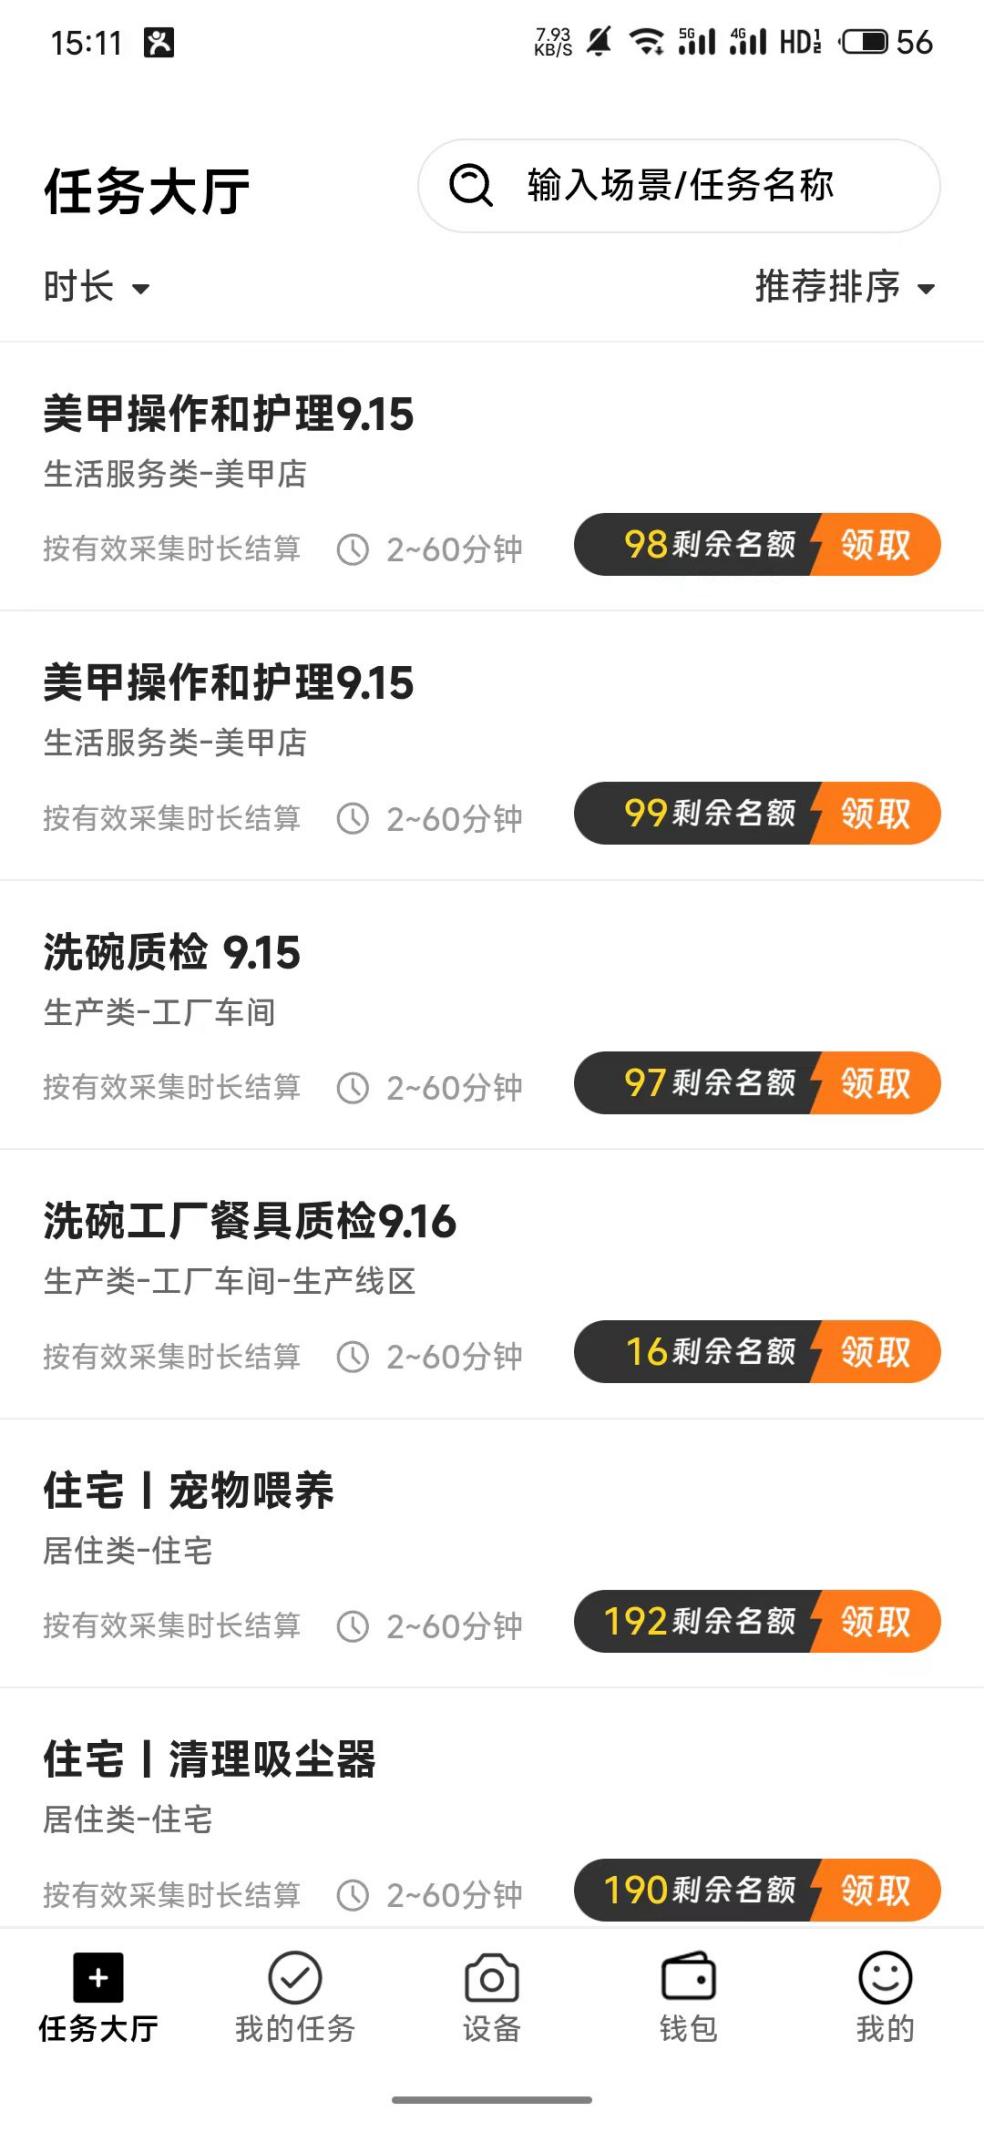
可以一次性接你能做的,然后APP点击开始采集,设备同步点击按钮开启采集,系统就会自动记录你完成这些任务的视频。
5小时下来,APP显示任务审核后,我赚了78元,而后签署灵活就业协议,试着提现支付宝,秒到账。
说实话,时薪15块6,不算高。主要是采集的任务中,实际有效时间不多。
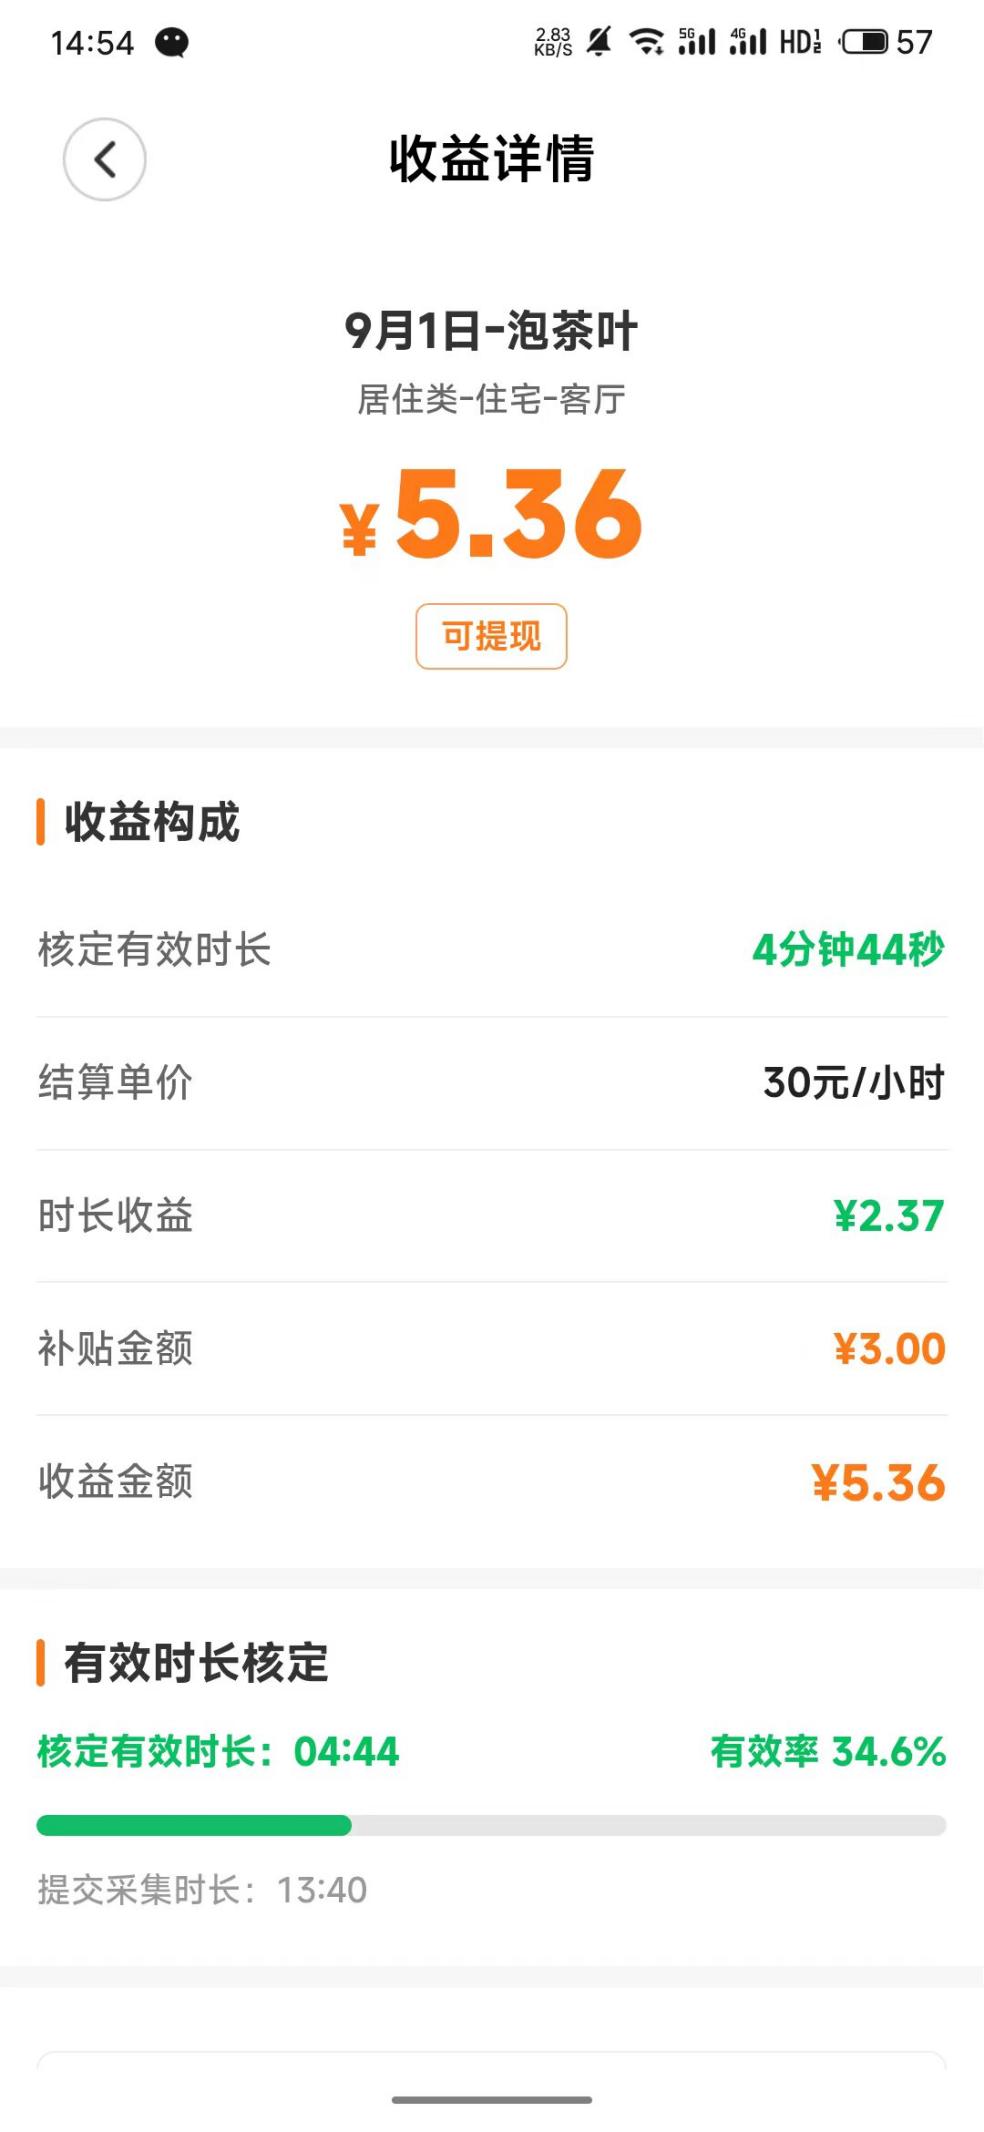
这其中还由于我偷了个懒,例如我接泡茶任务,主要是自己在泡茶喝茶的过程中,顺便带上设备,自己泡自己喝,偶尔第一杯茶,难免一些动作存在多余,中间还有停滞,但就这样,15分钟泡着喝下来,我也有了近5分钟的有效时间,按照30分钟/小时的价码,我赚了5.36元。
据了解,在为期一个月的内测期间,觅蜂派注册用户数达2万人,累计产生1.3万份采集任务提交。首批参与者来自不同年龄和职业,他们将日常劳动与专业技能转化为机器人训练数据。
而另外一个扫地的任务,5分钟时间,因为全程看着地面,清扫动作标准连贯,我竟然做到了100%的成功率。
但当我了解到这背后的逻辑后,我觉得这事儿有点意思。
02
为什么有人愿意花钱看你做家务?
这就要说到一个所有机器人公司都头疼的问题:数据不够用。
你可能觉得,现在AI不是很厉害吗?ChatGPT什么都懂。但你知道吗,语言模型之所以厉害,是因为互联网上天然就有海量的文字——论坛、新闻、小说、百科,随便抓。
但机器人要干活,这些文字没用。一个机器人要学会“擦桌子”,它需要看到:人手怎么握抹布、用多大力气、从哪个方向擦、遇到桌角怎么转弯、擦完把抹布放哪……
这些知识,互联网上没有。
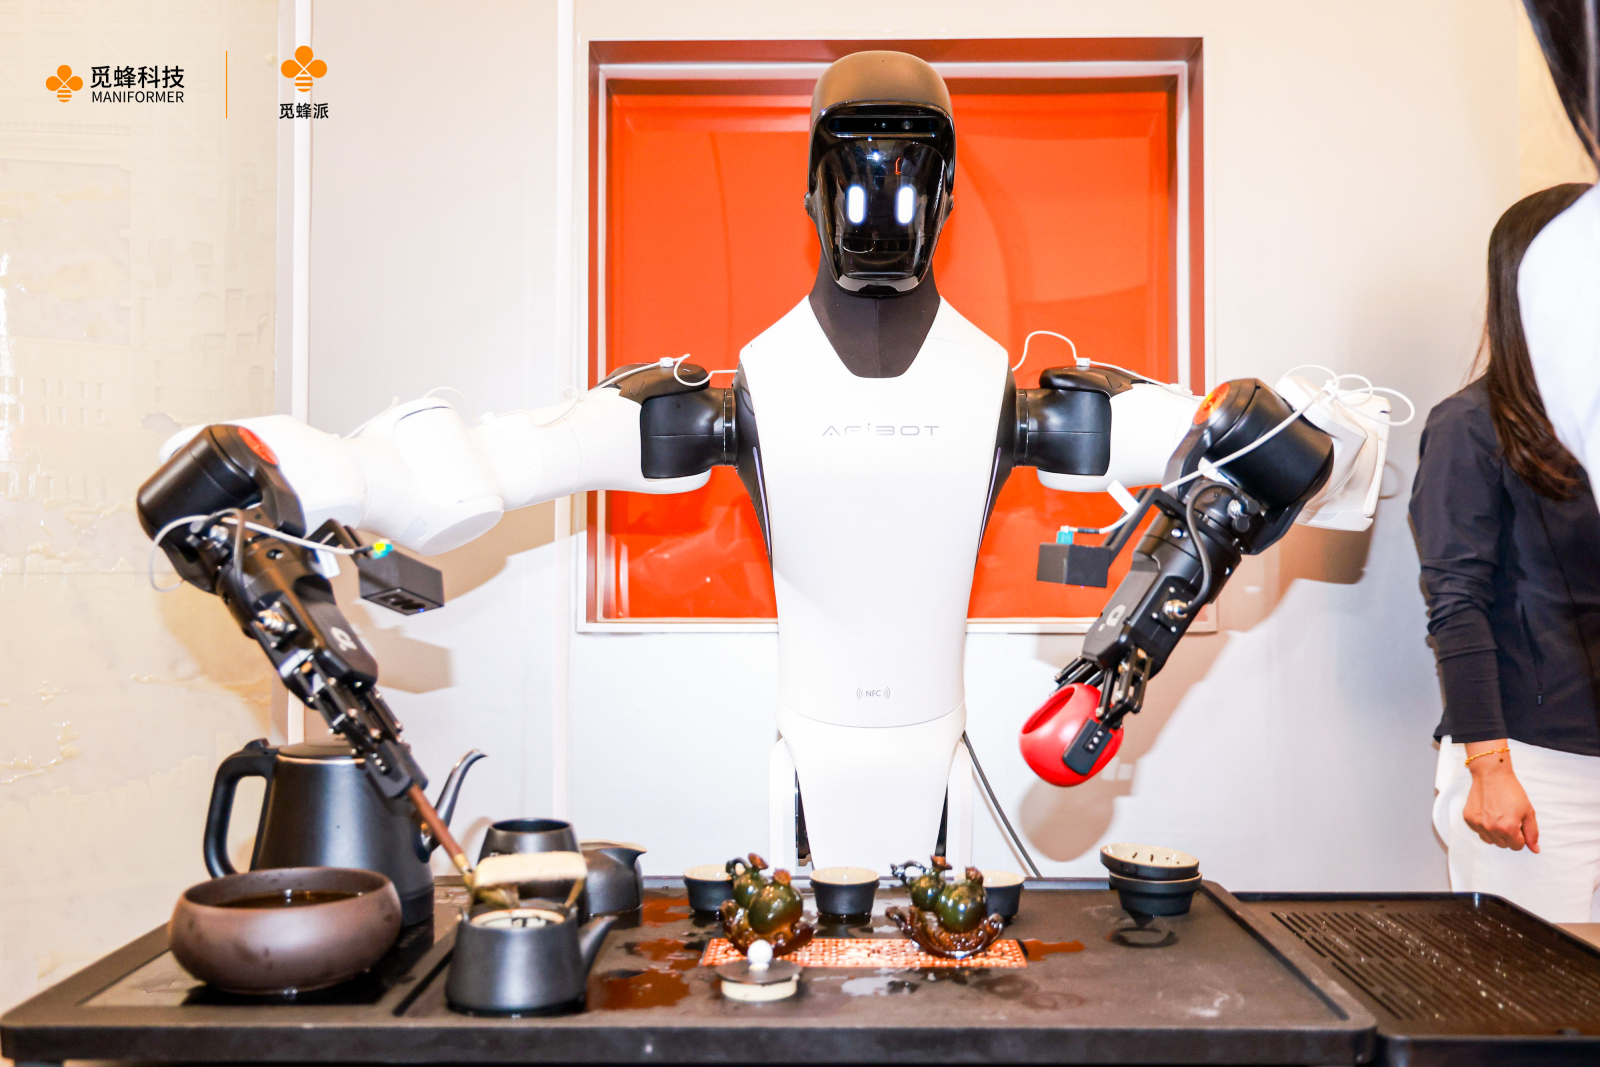
以前怎么解决?搭一个实验室,让操作员穿着动捕服,一遍一遍地做动作。一个工人干8小时,有效数据可能只有1小时。成本极高,效率极低。
觅蜂的思路是反过来的:你别“表演”给机器看,你正常干活就行。
食堂阿姨擦桌子;保洁拖地;你我在家泡茶、做家务,这些动作本身就是数据。设备戴在头上,就可以安静地记录,不打断你,不要求你“做标准动作”。
觅蜂科技的董事长姚卯青在活动现场说了一句话,我印象特别深:“未来让机器人真正干活儿,要学人怎么干,真实环境里的数据就是‘教材’。”
而我那5个小时,就是在给机器人写教材。
觅蜂派目前覆盖22大类场景、5000多个任务和50000多个真实环境,具体场景包括物流、仓储、住宿服务、教育、养老照护、餐饮、零售、公共服务、办公、汽车服务、医疗、建筑施工、交通出行、农业生产、文旅等。这些场景既包括取放、整理、搬运等通用操作,也包含装配、检修、照护等专业任务,可为机器人训练动态环境理解、精细动作控制、连续流程执行、风险判断和安全交互等能力提供数据。
03
78块钱背后,是一整套你没看到的系统
你可能好奇,我随便做做家务,录下来的视频,机器人就能学会了?
当然没那么简单。原始数据就像一堆散落的拼图碎片,得有人把它拼成完整的图。觅蜂有一套叫MEgo Engine的系统,干的就是这个活。
第一步,时间对齐。我头上戴的设备,如果时间对不齐,或者类似我这种任务中间停顿了,导致手都伸出去两秒了,画面才切过来,那数据就废了。但觅蜂把无线时间同步做到了0.5毫秒以内,比眨眼快几百倍,这让我的数据有效性就非常高。
第二步,动作翻译。系统会把我的动作拆解成机器人能理解的“语言”。比如“泡茶”是一个长任务,它会被自动拆成“取茶具→放茶叶→注水→端杯”这些原子动作和顺序。手部的位置、空间轨迹、动作情况,全都被提取出来。
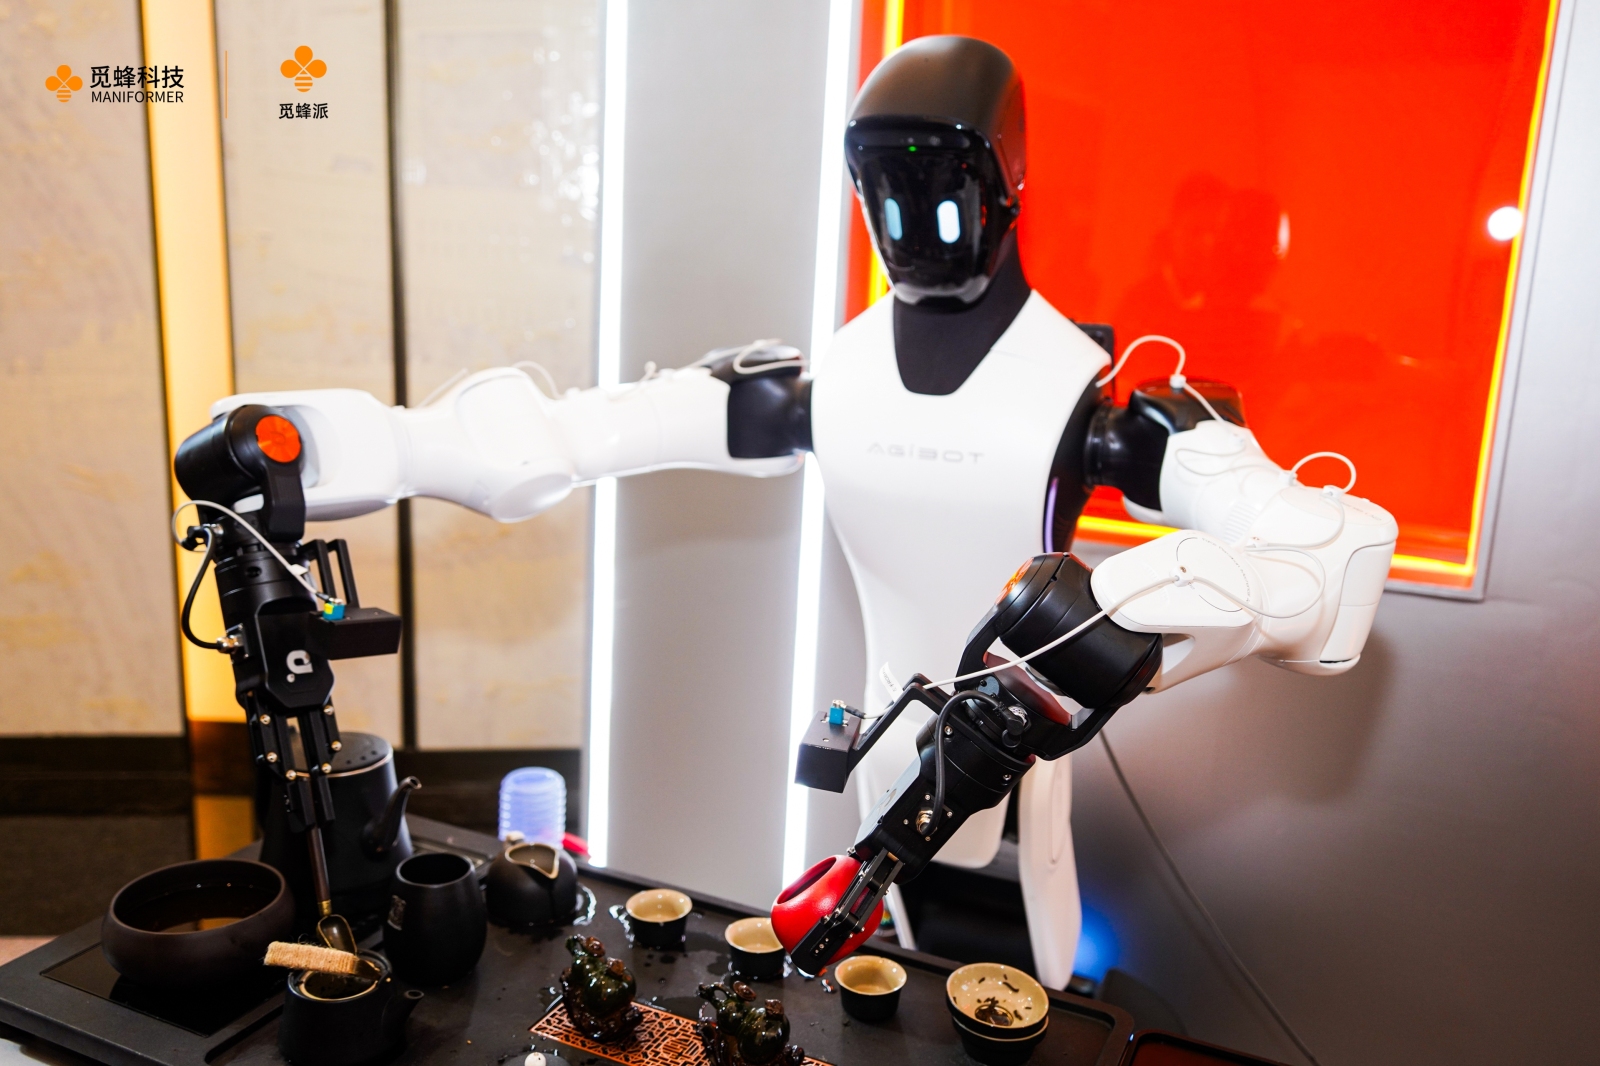
第三步,质量分级。在体验中以及我们与觅蜂的交流中发现,不是所有数据都一样值钱。系统会给每条数据打分,分成四类:动作标准的,用来教机器人模仿;动作丰富但不太规范的,用来做预训练;动作有问题甚至失败的,也有用,教机器人识别错误;特别罕见的场景,用来测试机器人的泛化能力。
“不过滤,只分级”——这是觅蜂的理念。在他们看来,每一条数据都有它的用途,关键是知不知道它能干什么。因此,发布会上,觅蜂派还宣布启动亿元补贴计划,覆盖采集任务、设备政策、线下服务和保险保障。2026年9月23日至10月22日推广期间,觅蜂派减免设备使用费,符合条件的用户可享受信用免押等政策。
04
我好奇的几个问题,也顺便问了
体验过程中,我特意测试了几个“刁钻”场景。
长任务暂停了怎么办?我试过做到一半停下来,过一会儿再继续。系统会自动判断这是同一个任务的延续,还是新任务的开始。不过说实话,如果断得太碎,一个完整的“泡茶”可能被切成两段,影响后续使用,任务数据的价值就直线下滑。这可能是众包模式下必须解决的工程难题。
另外泡茶场景的数据匹配度还有待提升,我注意到,同样是泡茶,在这套设备的体验过程中,我和我妈用的茶具、动作节奏、水壶位置、注水方式都不一样,我还会有焚香、赏茶等冗余动作。
我发现,系统会把“倒水”识别为一个通用原子技能,但如果你的动作和标准流程差太多,可能匹配不上预定义的技能库。而且家庭环境的光照、蒸汽遮挡、玻璃反光,从最终采集的数据情况来看,也都是光学采集的天然难点。
觅蜂这些众包的数据最后卖给谁?就我们了解到,大模型公司、机器人公司、科研机构都是核心买家。京东、腾讯等厂商也需要这些数据来去场景中训练更聪明的机器人。
05
这事儿跟普通人有什么关系?
你可能会想:我又不搞机器人,这跟我有啥关系?关系大了。
我了解到,觅蜂正在推一个叫“众包采集”的模式。简单说就是,任何人,只要愿意,都可以成为数据采集员。在这个模式下,人人皆可成为“机器人训练师”,即使不会编程、不懂机器人都没关系,会做饭、会整理货架就能接单采集数据、获得收入。在觅蜂派接单采集、秒级结算、随时提现,就能让亿万普通劳动者的经验汇成机器人的本能。
社区退休人员、宝妈、骑手、网约车司机……你干你的活,设备帮你记录,平台按有效数据付费。觅蜂CEO姚卯青说,未来这事会从“集中式”走到“半集中式”,最终变成“全民众包式”。
“就像外卖骑手、网约车一样,谁都可以来参与,把自己的技能、时间、经验变成可以被量化结算的东西。”
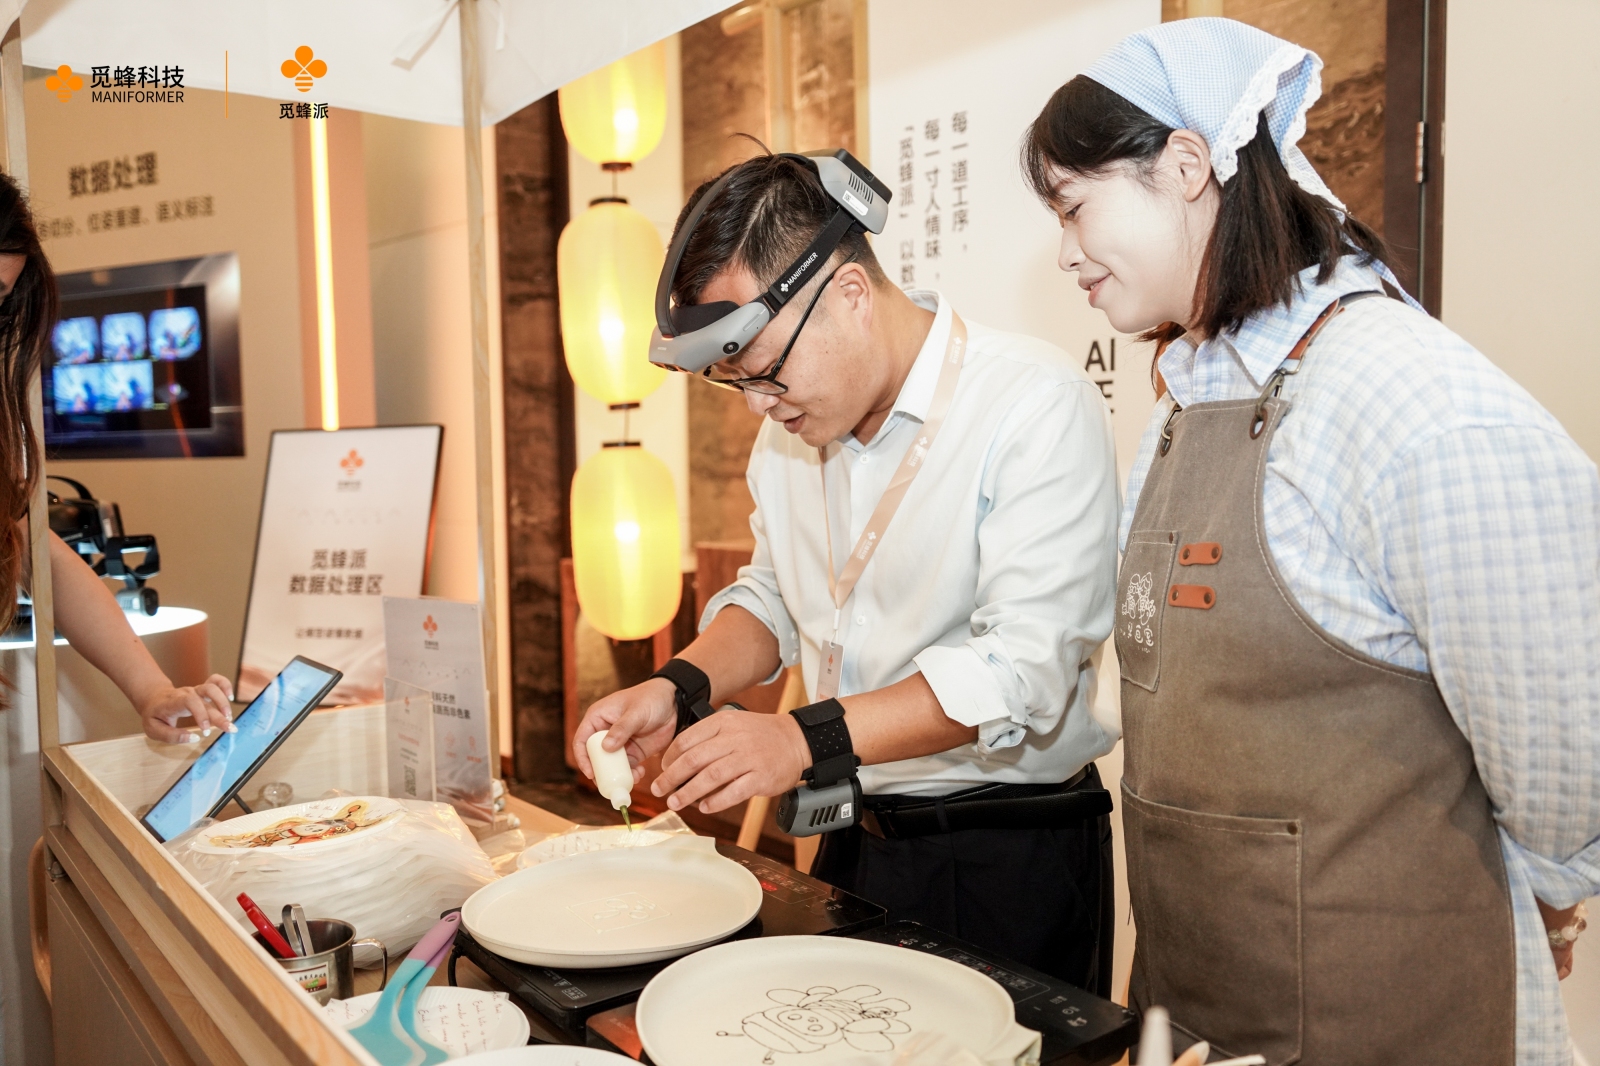
这意味着什么?意味着你做饭、打扫、修理、手工,这些原本不被看见的技能,未来可能都能变成收入。意味着“灵活就业”多了一种全新的可能。意味着当千万个普通人都在日常工作中贡献数据时,机器人的“教材”才真正够厚。
在我看来,5小时78元,这个收入现在还不高。但我体验感觉的,是一个正在成型的数据生产网络。
如今,觅蜂的两万套设备已经下线,百万小时数据已经入库。觅蜂说,通往真正的物理AI,需要上千万、上亿小时的数据,今天只是起点。
但更重要的是,这个起点是开放的。它不是少数几家公司在实验室里憋大招,而是让每个普通人都能参与进来。你擦一次桌子,我泡一杯茶,他修一次水管,这些看似平凡的日常,正在悄悄变成机器人的“教材”。此外,觅蜂科技通过发起“蜂巢数据共创行动”,联合全球伙伴打造开放高效的数据流通网络,让客户轻松找到数据,让服务商精准找到需求,共同加速具身智能的价值落地,为AGI时代的到来奠定数据基石。
这意味着,教材越厚,机器人学会干活的那天就越近。


